1.指令与数据的双通道
Cortex-M3 内核是 ARM 公司基于 ARMv7-M 架构设计的一款 32 位 RISC(精简指令集计算机)内核,是专为嵌入式应用而优化的微处理器。
Cortex-M3 内核采用哈佛结构,与传统的冯・诺伊曼结构不同,它将程序指令存储和数据存储分开,拥有独立的指令总线和数据总线。这就好比工厂里的两条独立生产线,一条专门负责生产产品(执行指令),另一条专门负责运输原材料(传输数据),两者可以同时进行工作,互不干扰。
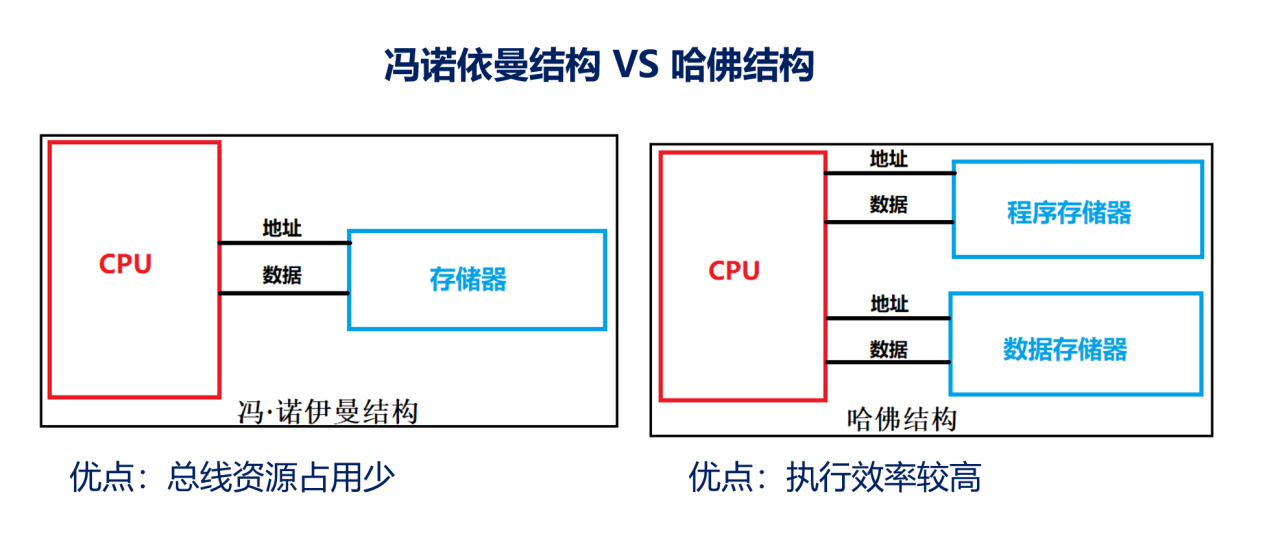
在冯・诺伊曼结构中,指令和数据共享同一总线,只有一条生产线,既要生产产品又要运输原材料,在指令和数据频繁交换时,容易出现总线冲突,导致效率降低。而哈佛结构则有效避免了这个问题,它允许在一个机器周期内同时获得指令字(来自指令存储器)和操作数(来自数据存储器),提高了数据的吞吐率和指令执行效率。
2.内核架构
下图为Cortex-M3内核架构示意图。
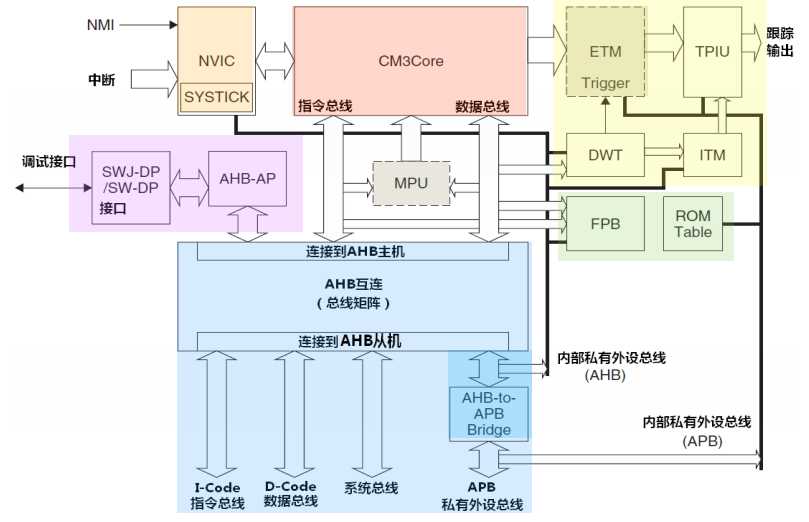
Cortex-M3内核采用哈佛结构,拥有独立的指令总线(I-Code)和数据总线(D-Code),支持取指与数据访问并行执行,内部集成 ALU、32 位寄存器组、指令解码器及取指单元,支持单时钟周期乘法和硬件除法,通过 3 级流水线进一步优化指令执行速度。
NVIC(嵌套向量中断控制器)紧密耦合于内核,支持 1~240 个物理中断和 256 级优先级,采用向量中断机制,中断发生时自动完成寄存器压栈(PC、xPSR、LR、R0-R3、R12),同时指令总线并行获取异常向量,实现低延迟中断响应,中断结束后寄存器自动恢复。
总线矩阵作为 AHB 互联控制核心,支持多总线主机并行访问不同内存区域,通过写缓冲和位带操作优化数据传输效率,连接 I-Code、D-Code、系统总线及 APB 外设总线。
MPU(可选)将存储器划分为多个区域,可独立配置访问权限。
调试接口支持 SW-DP 或 SWJ-DP,通过 AHB-AP 实现对内核及外设的调试访问,集成 ETM、TPIU 支持指令流跟踪与实时数据监控。
3.三级流水线与分支预测
Cortex-M3 内核采用三级流水线技术,将指令的执行过程分为取指(Fetch)、译码(Decode)、执行(Execute)三个阶段 。在理想情况下,每个时钟周期都有一条指令进入流水线,同时有一条指令完成执行,就像汽车生产线上,每一个工位都在有条不紊地工作,一辆辆汽车依次下线。
但是,当遇到分支指令(如 if - else 条件判断、循环语句等)时,流水线可能会出现断流的情况。因为在分支指令的条件判断结果出来之前,处理器无法确定下一条要执行的指令地址,这就好比汽车生产线上突然遇到一个岔路口,不知道该往哪个方向走,只能停下来等待指示,导致流水线的效率降低。
为了解决这个问题,Cortex-M3 内核引入了分支预测功能。分支预测器会根据程序的执行历史和当前的指令情况,预测分支指令的执行方向,提前将预测的下一条指令取到流水线中,这样就可以减少流水线的断流时间,提高执行效率。
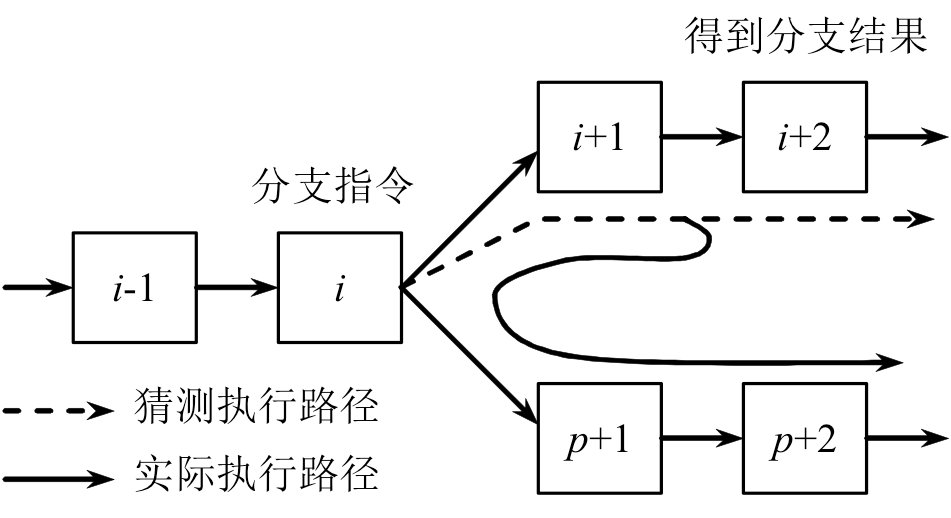
例如,在一个循环语句中,分支预测器可以预测到循环会继续执行,提前将循环体内的指令取到流水线中,让流水线保持高效运行。虽然分支预测并不能保证 100% 准确,但在大多数情况下,它可以显著提高处理器的性能。
4.核心寄存器组
下图为Cortex-M3核心寄存器组示意图。
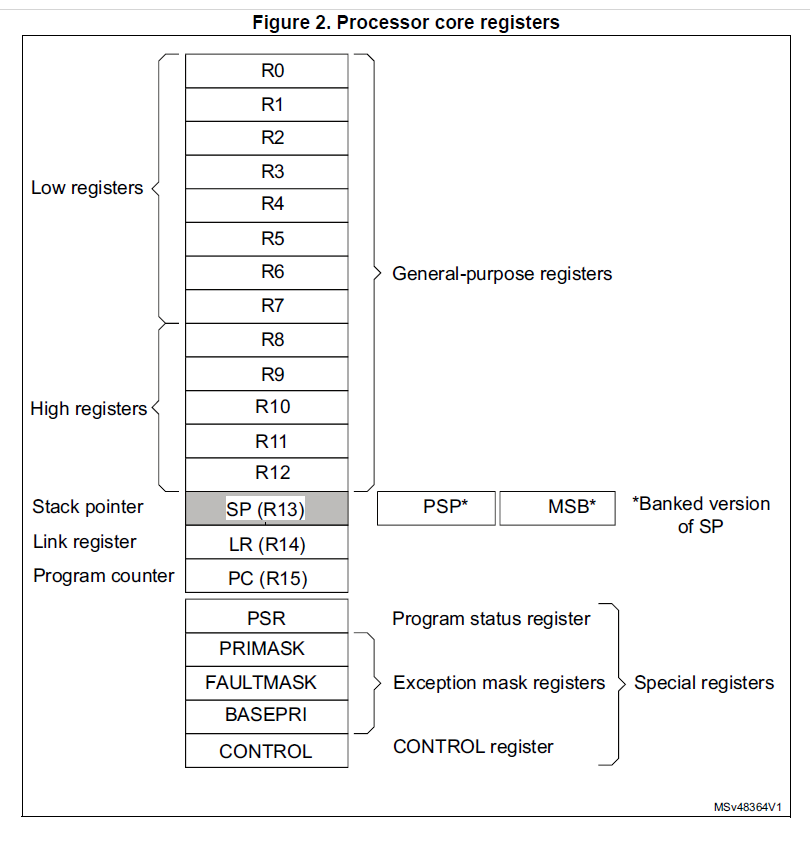
上图展示了典型的 ARM 架构处理器寄存器布局,处理器核心寄存器可分为通用寄存器、专用寄存器、堆栈指针(SP)、链接寄存器(LR)、程序计数器(PC)、程序状态寄存器(PSR)、异常屏蔽寄存器、控制寄存器(CONTROL)等,各部分功能与结构如下:
4.1通用寄存器
由R0 - R12组成,属于低寄存器(Low registers)和高寄存器(High registers)范畴,是处理器执行指令时存储操作数、中间结果或地址的存储单元,支持灵活的数据存储与运算操作。
4.2 堆栈指针
物理实现:R13用作堆栈指针,关联两个独立的物理寄存器——主堆栈指针(MSB)和进程堆栈指针(PSP)。
选择机制:系统复位后默认使用MSB,具体堆栈指针的选择由CONTROL寄存器控制。
堆栈模型:采用满递减堆栈(Push时先写数据再减指针,Pop时先加指针再读数据),且堆栈指针始终4字节对齐(最低两位硬性规定为0)。
4.3 链接寄存器
功能:R14作为链接寄存器,承担两项关键职责:
1.函数/子程序调用时,保存返回地址,确保程序执行流程的连续性;
2.中断服务程序中,其值用作EXC_RETURN,指示中断结束后处理器如何恢复状态。
4.4 程序计数器
功能:R15是程序计数器,直接指向当前正在执行的指令地址。
地址特性:读取到的PC值最低位始终为0(因最低位实际为Thumb状态位,读取时被硬件自动屏蔽)。
4.5 程序状态寄存器
结构:PSR是复合寄存器,由三部分组成:
应用程序状态寄存器(APSR):包含NZCVQ等条件标志位(用于判断运算结果的符号、零、进位、溢出等状态);
中断程序状态寄存器(IPSR):存储当前正在服务的中断编号;
执行程序状态寄存器(EPSR):包含可中断-继续指令(ICI)状态位和Thumb状态位(T位)。
4.6 异常屏蔽寄存器
PRIMASK:将此寄存器置1可屏蔽所有优先级可配置的中断,仅保留NMI(不可屏蔽中断)和Hard Fault异常响应。
FAULTMASK:此寄存器设定了一个优先级阈值,优先级高于该阈值的中断会被屏蔽。
4.7 控制寄存器
功能:用于系统级控制,需通过MRS/MSR指令访问,核心作用包括:
1.配置处理器的堆栈指针选择(MSP或PSP);
2.确定当前的特权等级(特权模式或非特权模式)。
4.8 特殊寄存器
BASEPRI:配置优先级阈值,高于该阈值的中断会被屏蔽。
CONTROL:控制堆栈指针选择与特权等级。
处理器核心寄存器通过通用寄存器实现数据存储与运算,堆栈指针管理堆栈操作,链接寄存器保障程序流程,程序计数器定位指令执行位置,程序状态寄存器记录状态与中断信息,异常屏蔽寄存器控制中断响应,控制寄存器实现系统级配置,各部分协同完成处理器的指令执行、状态管理与系统控制任务。
5.空间分配
Cortex-M3内核拥有32位地址总线,具备4GB的寻址空间。并且,这4GB空间按照功能被划分为多个标准区域,各区域有着明确的地址范围以及特定用途。
下图为内存映射示意图。
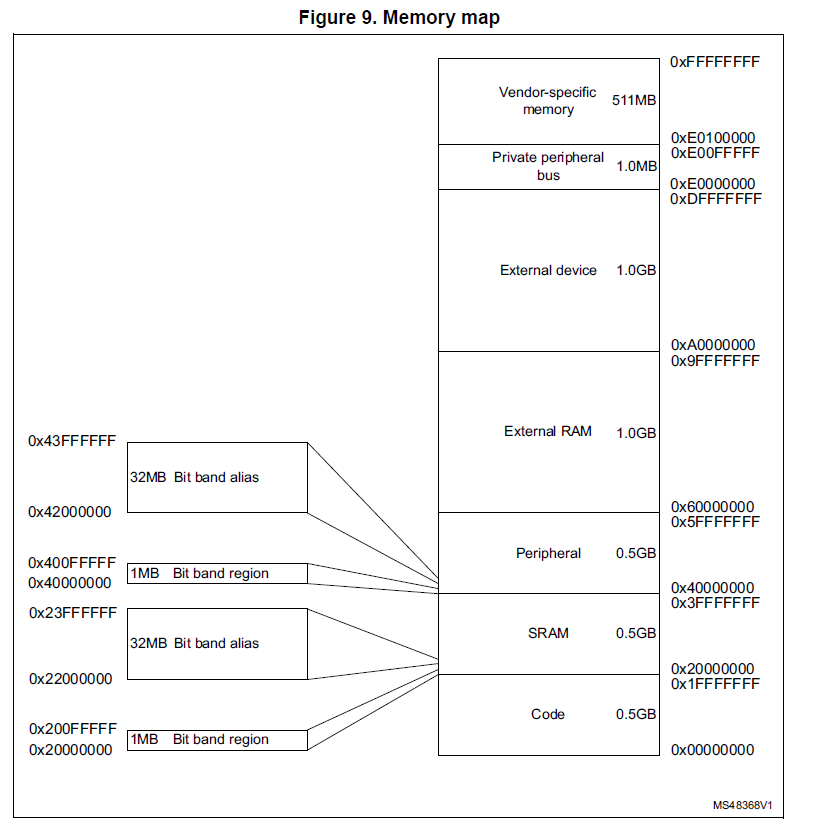
代码区(Code)
地址范围是0x00000000 - 0x1FFFFFFF(512MB),主要用于存放指令,像Flash、ROM等存储器都映射到该区域。同时,系统复位后,中断向量表默认也位于此区域的起始地址。
SRAM区
其地址范围为0x20000000 - 0x3FFFFFFF(512MB),主要用于数据存储,片内SRAM通常就映射在这里。
外设区(Peripheral)
其地址范围是0x40000000 - 0x5FFFFFFF(512MB),包含APB/AHB总线外设。
外部RAM区
其地址范围为0x60000000 - 0x7FFFFFFF(512MB),主要用于扩展外部RAM,例如连接外部SRAM芯片。
外部设备区(External device)
其地址范围是0x80000000 - 0xDFFFFFFF(1.5GB),用于映射外部设备,如LCD、以太网控制器等。
系统区
其地址范围是0xE0000000 - 0xFFFFFFFF。子区域划分为:
专用外设区(0xE0000000 - 0xE00FFFFF,1MB):包含NVIC(中断控制器)、SysTick(系统定时器)、TPIU(跟踪端口接口单元)等核心外设。
保留区域(0xE1000000 - 0xFFFFFFFF,约511MB):未定义或保留。
6.寄存器地址空间
Cortex-M3内核的寄存器地址空间根据类型不同,映射在以下区域:
6.1 内核专用寄存器
地址范围:0xE0000000 - 0xE00FFFFF(1MB),属于系统设备区。
包含内容:嵌套中断向量控制器(NVIC)、系统滴答定时器(SysTick)、调试寄存器等核心外设寄存器,以及特殊功能寄存器(如PSR、中断屏蔽寄存器PRIMASK/FAULTMASK等)。
特点:此区域为内核固定映射,用于访问处理器核心的系统级功能。
6.2 外设寄存器
地址范围:0x40000000 - 0x5FFFFFFF(512MB),属于外设区。
包含内容:芯片厂商扩展的外设寄存器(如GPIO、UART、SPI、定时器等),具体地址由厂商定义(如STM32的外设寄存器映射于此区域)。
6.3 通用寄存器
R0-R12(通用寄存器)、R13(SP)、R14(LR)、R15(PC)等内核通用寄存器无直接地址映射,通过指令直接访问,不占用4GB地址空间中的物理地址。
7.嵌套中断向量控制器
NVIC(Nested Vectored Interrupt Controller,嵌套向量中断控制器)是Cortex-M3内核内建的中断管理核心部件,与CPU紧密耦合,负责中断的优先级管理、嵌套控制、向量地址获取等关键任务,被称为微控制器的“中断交通指挥中心”。其核心功能为:
中断优先级管理:支持8~256个可编程优先级级别(具体数量由芯片厂商定义,如STM32F103支持60个中断源),优先级数值越小,逻辑优先级越高。
中断嵌套机制:允许高优先级中断打断低优先级中断的执行,确保关键任务优先响应(如工业控制系统中的紧急故障处理)。
向量中断处理:中断发生时,自动从中断向量表获取服务函数入口地址,无需软件查询中断源,大幅降低中断延迟。
NVIC寄存器采用存储器映射方式访问,基地址为0xE000E000,关键寄存器如下表所示: