很多初学编程的人都会陷入同一个困境:语法看得懂、例题能抄,轮到自己动手写代码,到处都是 bug,反复调试,越写越怀疑自己是不是没有学编程的天赋。
其实问题不在于你记不住关键字,而是你还在用人类的思维习惯,去指挥一台完全没有常识、读不懂潜台词的机器。
在工作场景中,我们经常会碰到这样的场面:导安排工作,一句“这个你看着办”,人能办到七八分,这是理解领导意图的能力。
但如果你把这句话原封不动交给计算机,它会直接卡住,给不出任何结果。计算机不会揣摩意图、不会领会精神、更不会自主发挥。它只有唯一的工作方式:严格按照程序员预先写好的规则,一步一步,机械执行。
想学会编程,最先跨过的一道门槛,就是思维反转:不是让机器来懂你,而是把脑子里模糊、笼统、带着主观留白的想法,翻译成机器可以落地、没有歧义的显式规则。
用来完成这次翻译的,就是程序逻辑的四大基石:变量、顺序、分支、循环。
编程本质,是把人类模糊的目标,建模成一套确定、可分步执行、状态可保存的指令序列。
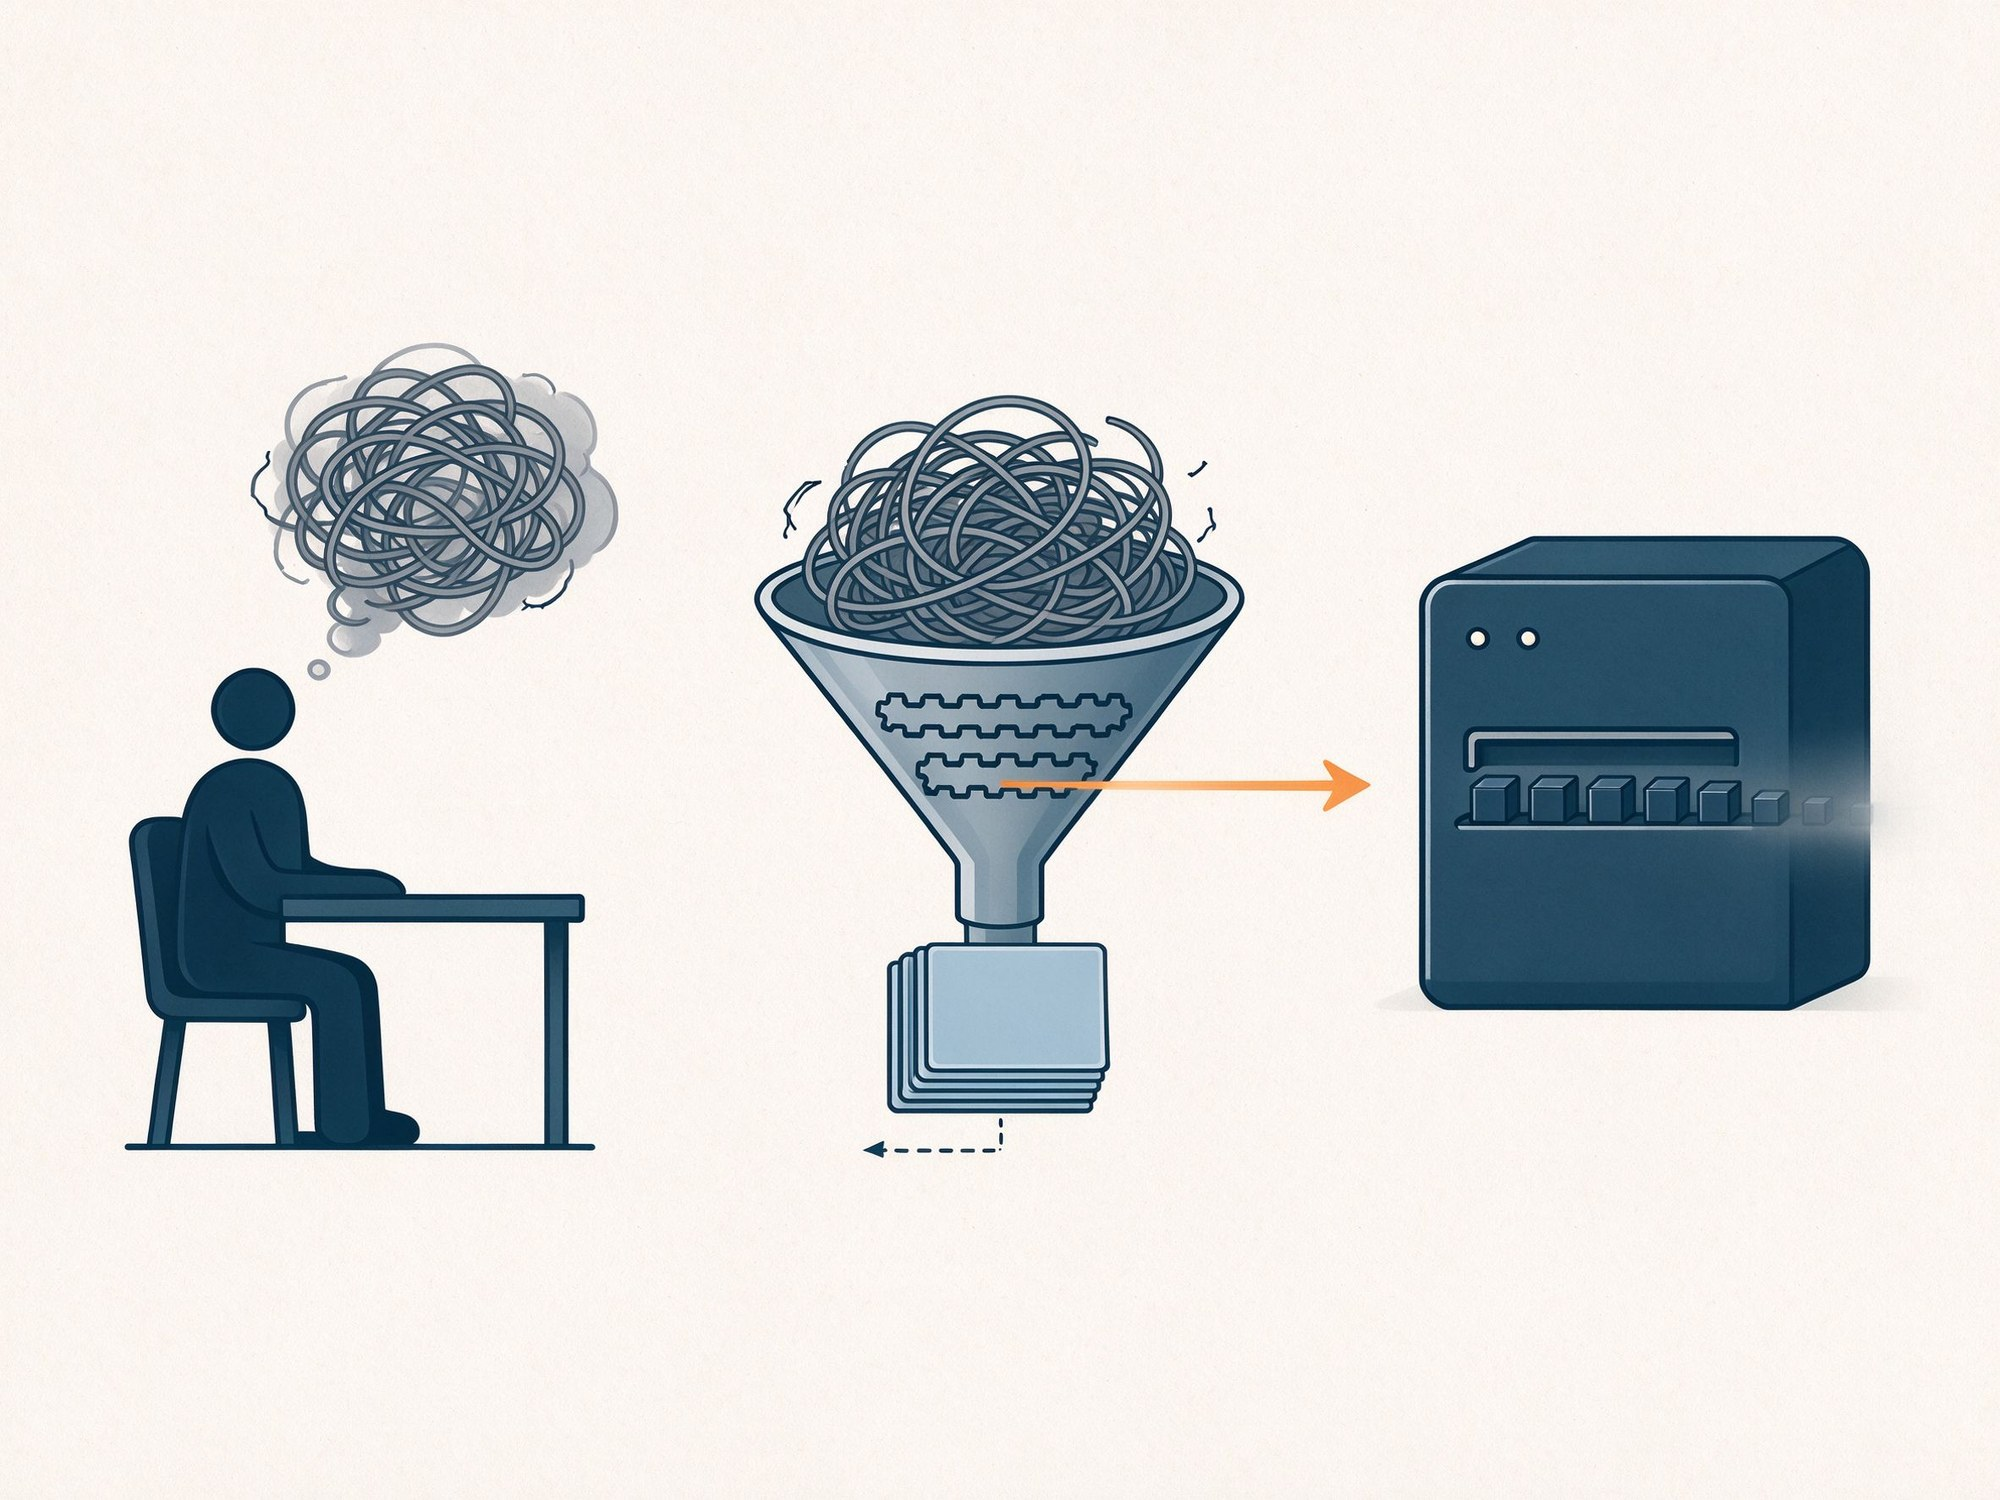
图1 把脑子里模糊的想法,翻译成机器能执行的规则
1.它不讲情理,只认刚性规则
人与人沟通天然允许模糊边界。一句 “把桌子收拾干净”,人会自动判断:哪些东西该收、灰尘到什么程度算干净、先做哪一件。我们自带常识,能自动补齐所有没有说出口的隐含条件。
计算机没有这套能力。不在指令里明确定义的行为,它绝不会主动去做。所有交给程序的规则,必须同时满足三条硬性约束:
1.语义无歧义:不存在 “差不多”“酌情处理”“大概优先” 这类描述,每一条判定都要有清晰分界线;
2. 操作原子化:目标不等于步骤。“把文件处理好”是最终目标;“打开文件、写入内容、关闭句柄” 才是可以执行的原子指令;
3. 状态显式存储:机器不会保留隐性记忆。中间计算结果如果不主动存入变量,执行过后就直接消失,不会自动留存。
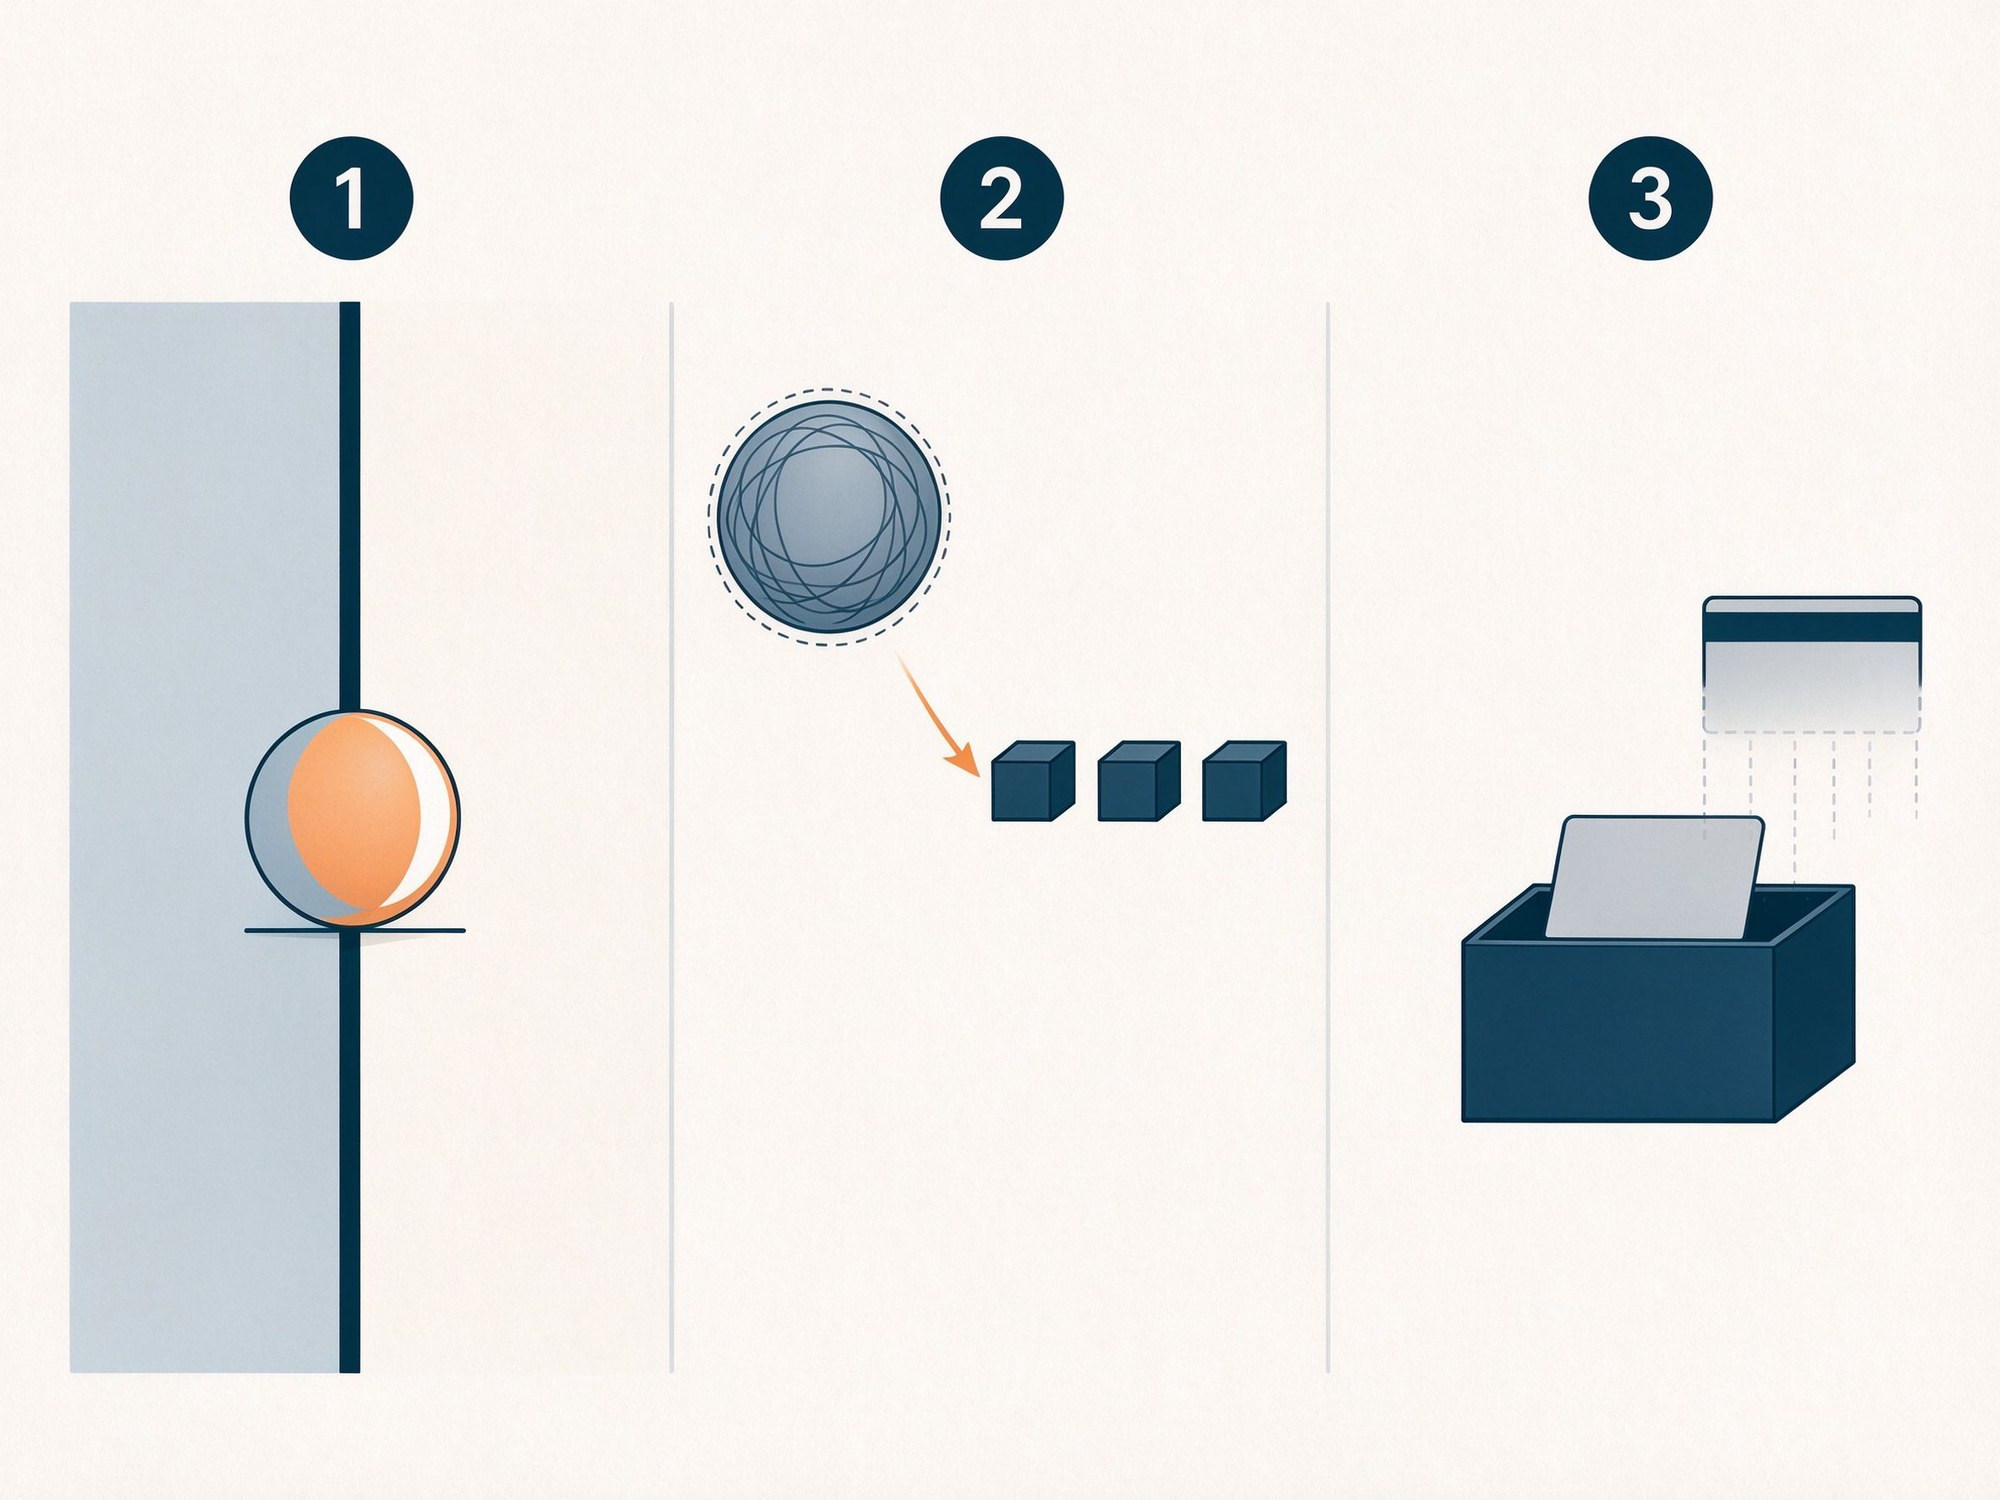
图2 交给计算机的规则必须同时满足三条硬性约束
2.顺序:自上而下执行,真正难点是前置依赖
程序默认的执行模式就是顺序:写在前的先跑,写在后的后跑,它不会凭借常识自行调换工序。
我们用泡茶来举例:烧开水、放入茶叶、静置焖泡、倒出茶汤,按这个顺序,一杯清茶就泡好了。如果把 “倒出茶汤” 挪到 “放入茶叶” 前面呢?单独看每一步都没有问题,指令本身全都合法,但它就死板地先倒水、再放茶叶。最后得到的只是一杯白开水。
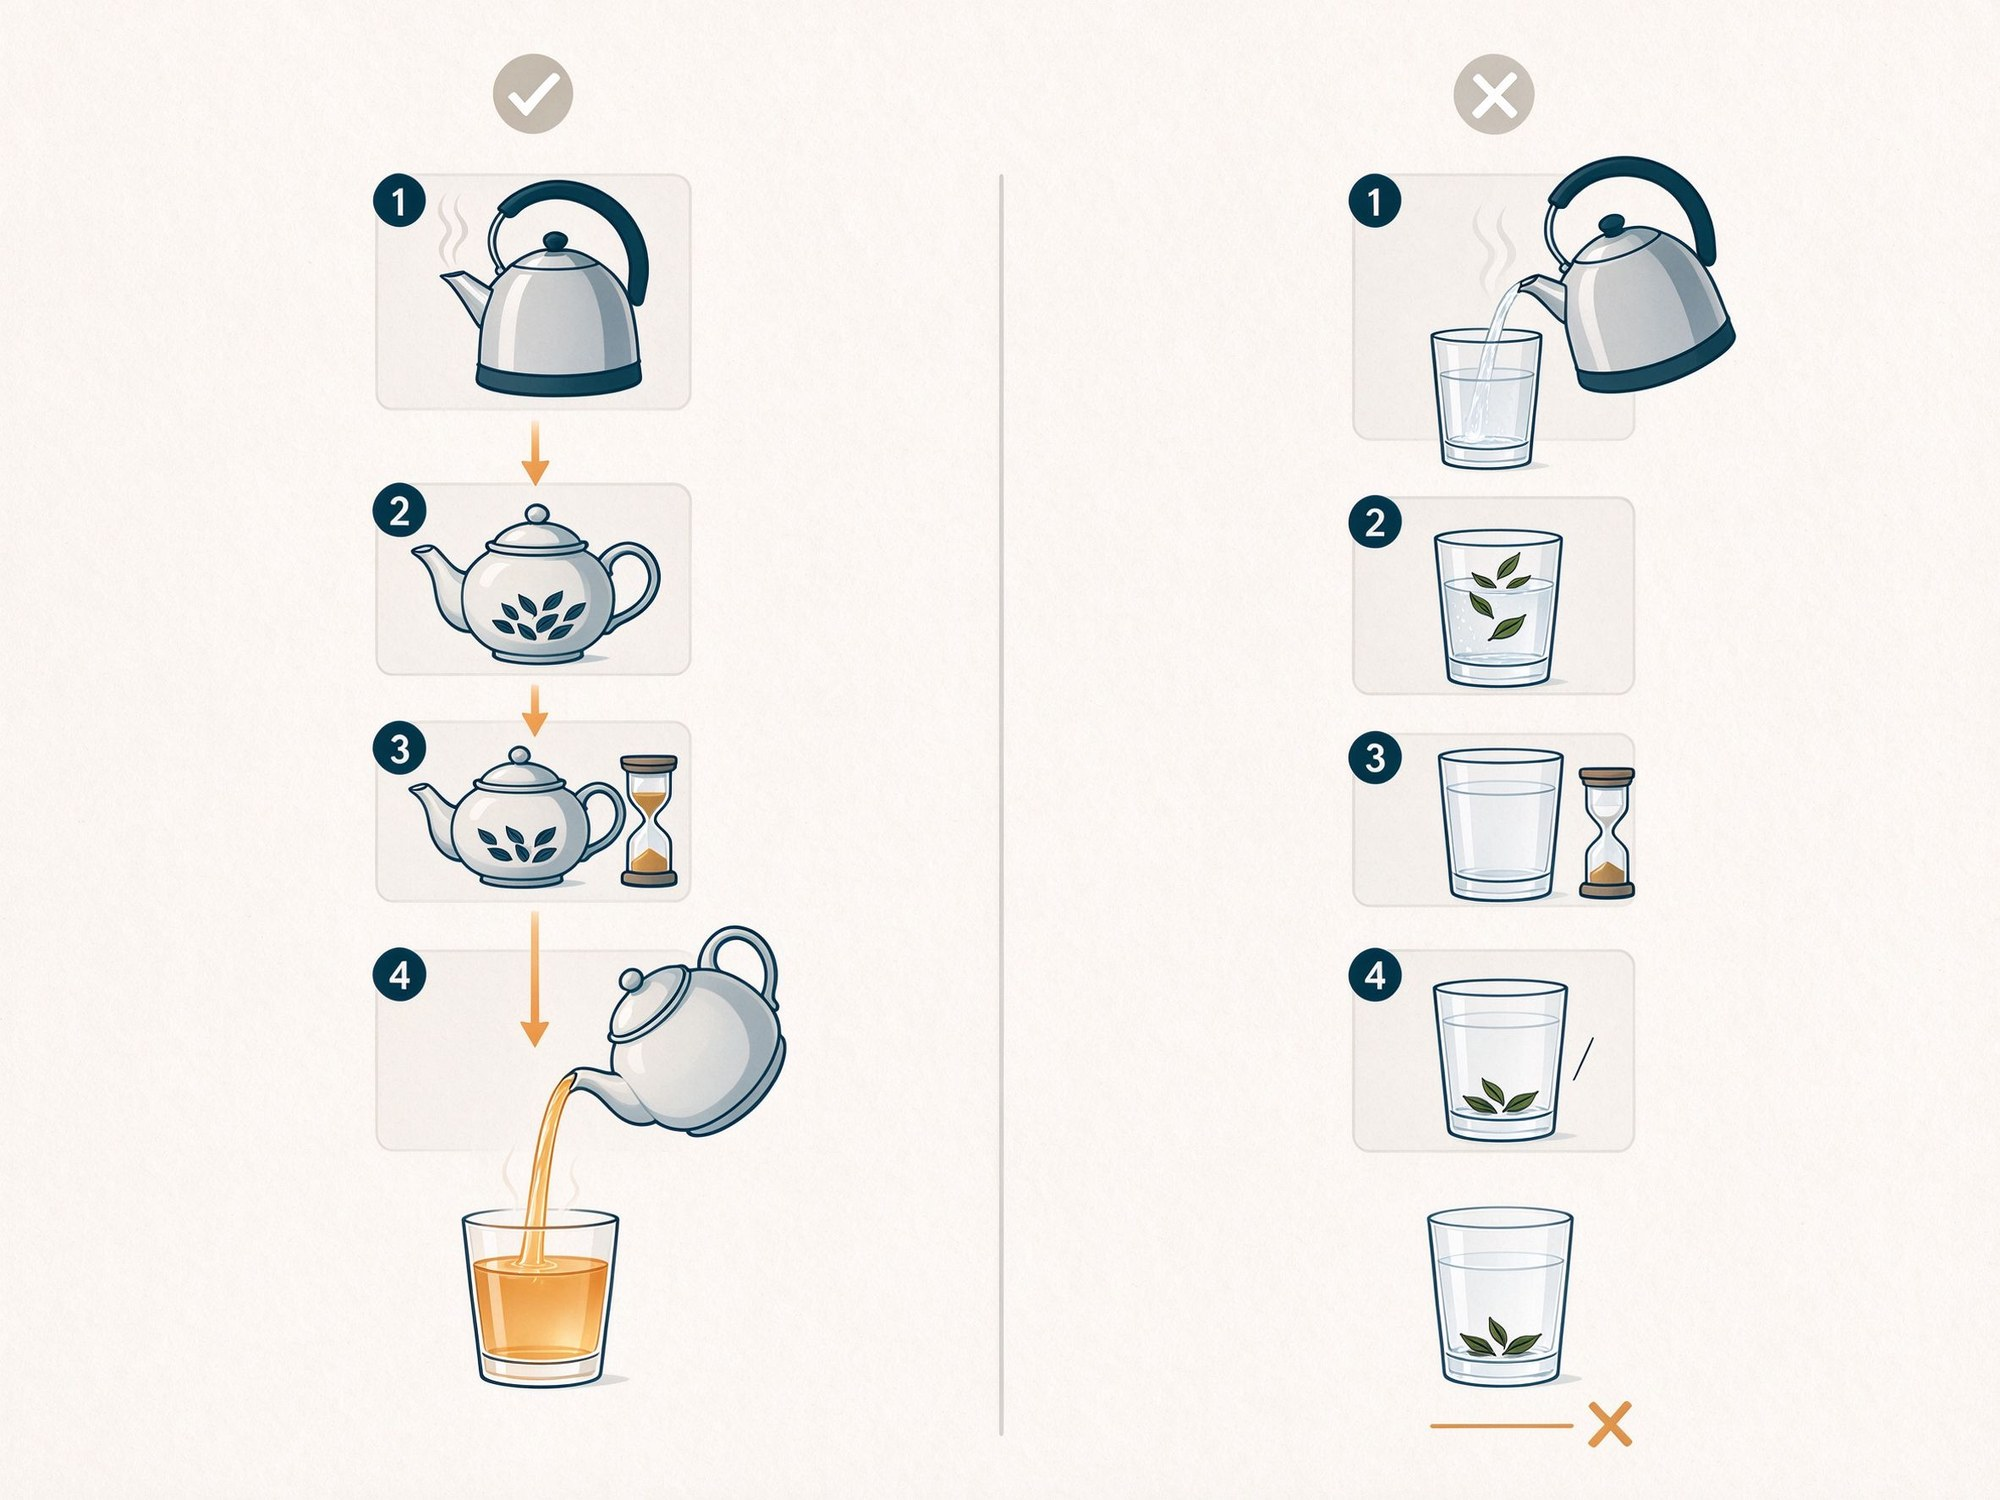
图3 同样四个步骤,顺序错了只剩一杯清水
顺序执行最大的坑,不是代码跑不起来,而是时序依赖。每一条指令运行之前,它需要的数据、资源、前置结果,必须提前准备就绪。
新手在这里有两个高频翻车点。
第一个,交换两个变量,一不小心就把原始数据弄丢了。桌上放着两只杯子,A 装清水,B 装茶水。我们的目标是把水换到 B、茶水换到 A。能不能直接互相倾倒?不行,这么一做,两杯液体混在一起,原来的茶水就彻底丢失了。正确的思路,是先准备一只空杯子,把茶水暂存起来,再把水倒进 B,最后把暂存的茶水倒回 A。写代码的时候,不少同学贪图省事,只用两句赋值就想完成交换;第一句执行完,A 的原值直接被覆盖,再也无法恢复。别忘了:计算机不会主动帮你记住这个被覆盖掉的数据。
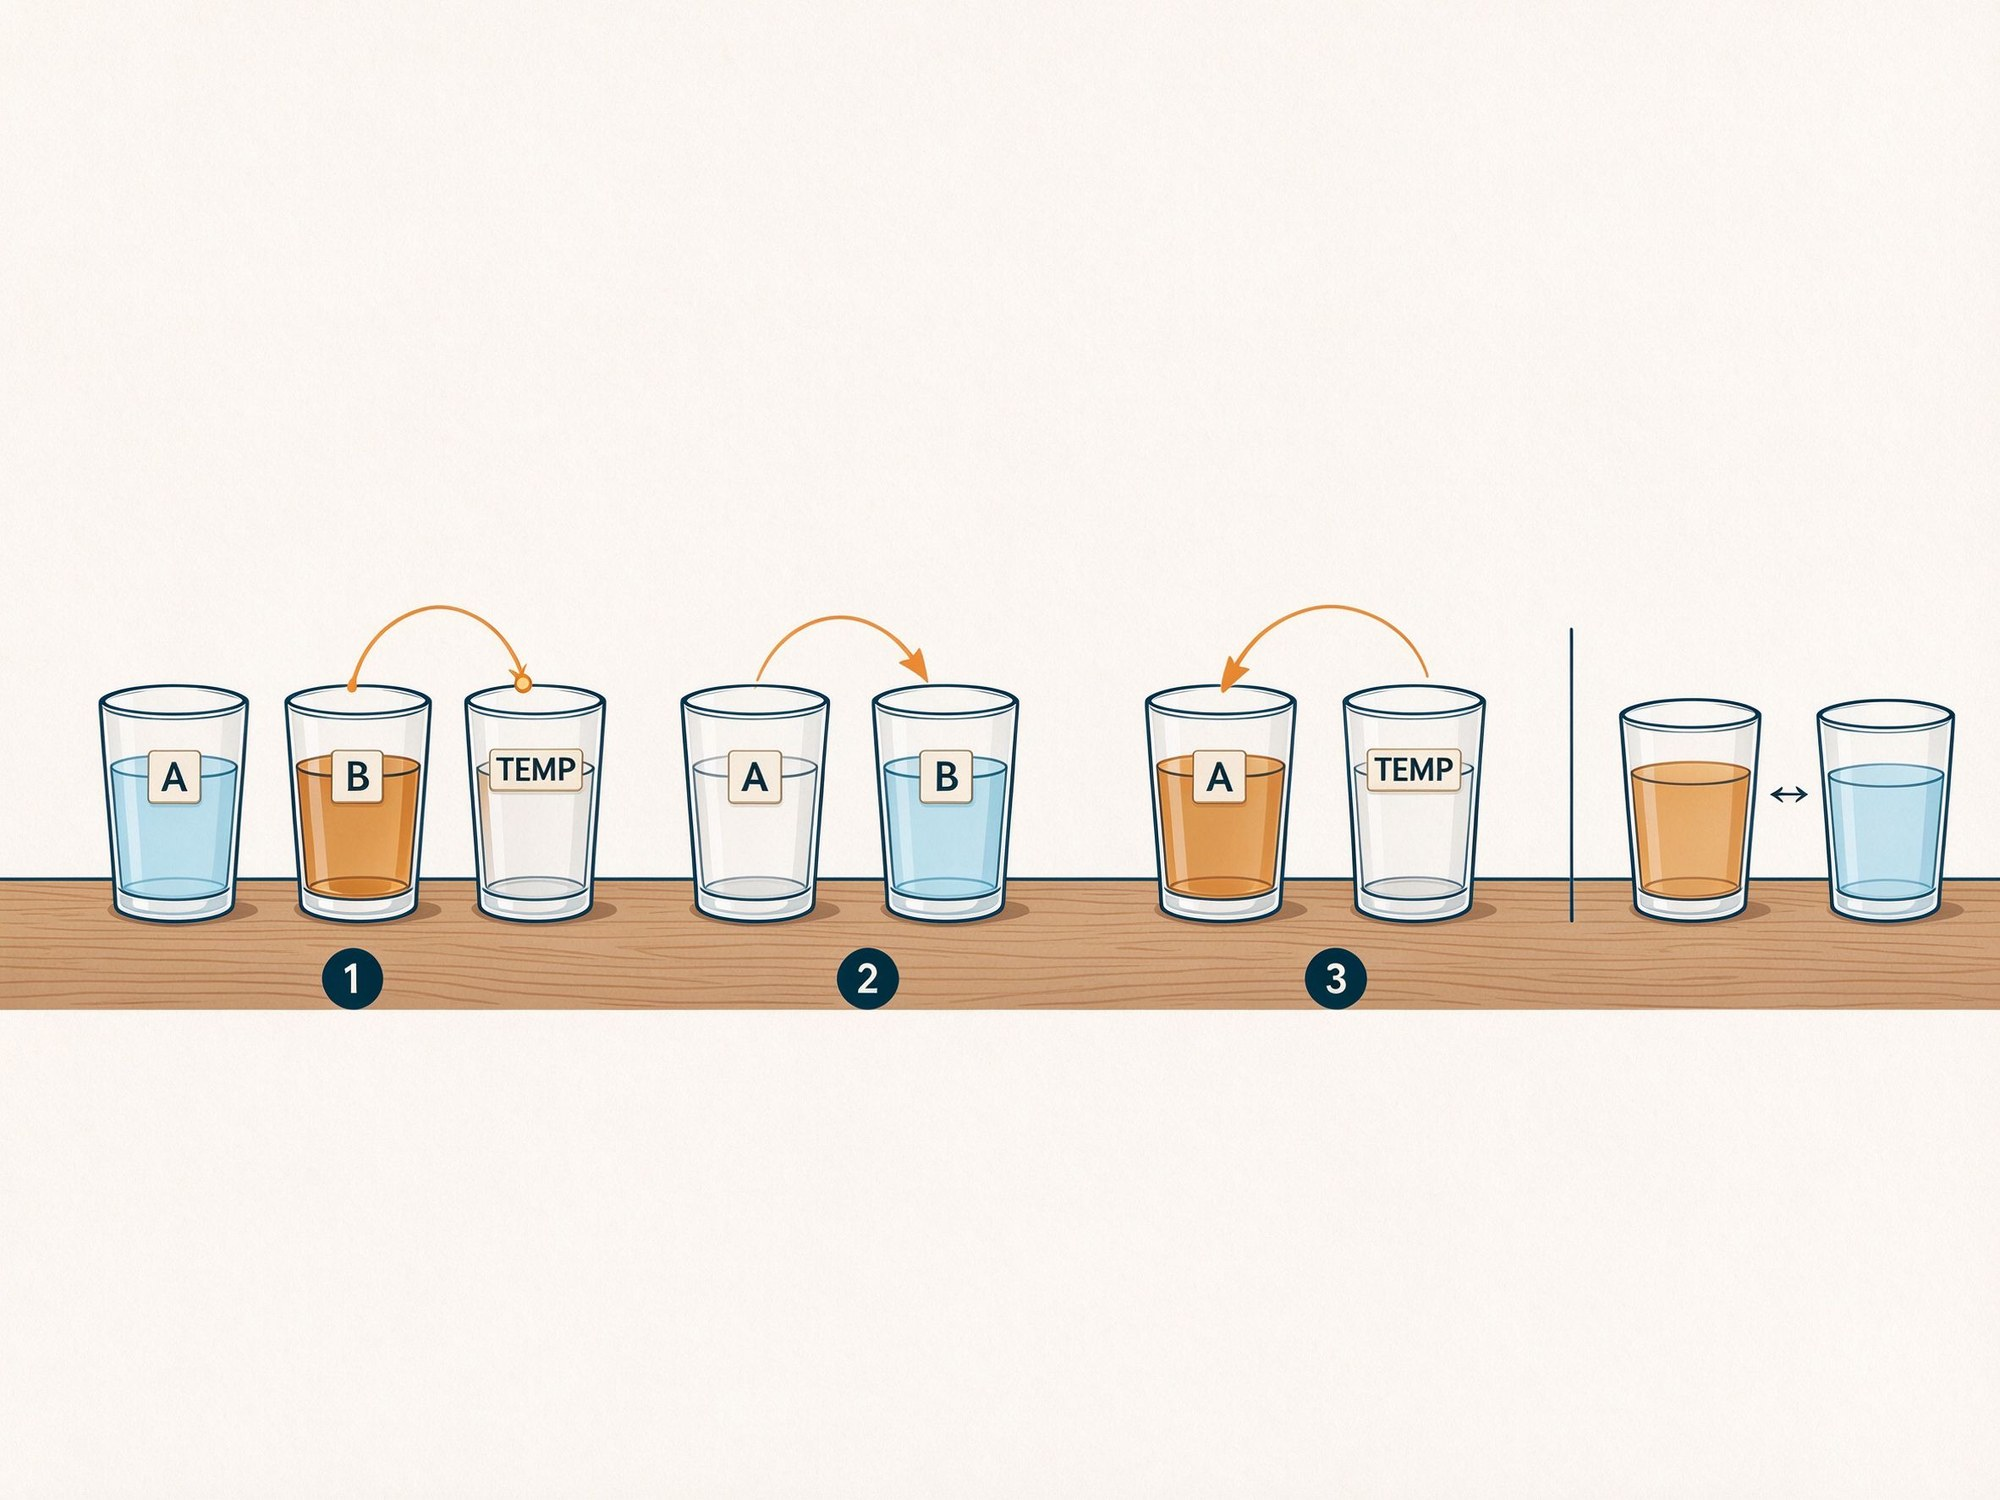
图4 借助第三只空杯 TEMP,才能安全交换两个值
第二个坑,使用尚未赋值的变量。你写了一段计算总分的代码,逻辑看着很漂亮,可它要用到的平均值,是在后面的语句才会计算生成。当程序执行到这一步时,存放平均值的位置还没有存入有效数据,它就拿着这片 “空白” 参与运算,最后得到的要么是 0,要么是一串毫无意义的随机值。
顺序执行的重点,不是先后,而是保证每一步的依赖,在它运行之前就绪。
3.分支:每一条路都要有去处
在现实生活里,人们几乎做每一件事,都在做判断:如果外面下雨,那就带上伞;如果不下,就不用带。如果账户余额充足,就直接下单;余额不够,就提示用户去充值。这种如果…… 就……,否则……的结构,放到程序当中,就是我们所说的分支。
分支的判定条件,只有两种结果,成立,或者不成立。不存在 “部分成立”,也不存在 “看情况而定”,更没有所谓 “七成算满足条件” 这一说。
正是这个特点,决定了一个规则:
现实里那些模模糊糊、凭感觉拿捏的判断,一旦落到代码里,都必须划出一条清晰完整的分界线,或者成立或者不成立。
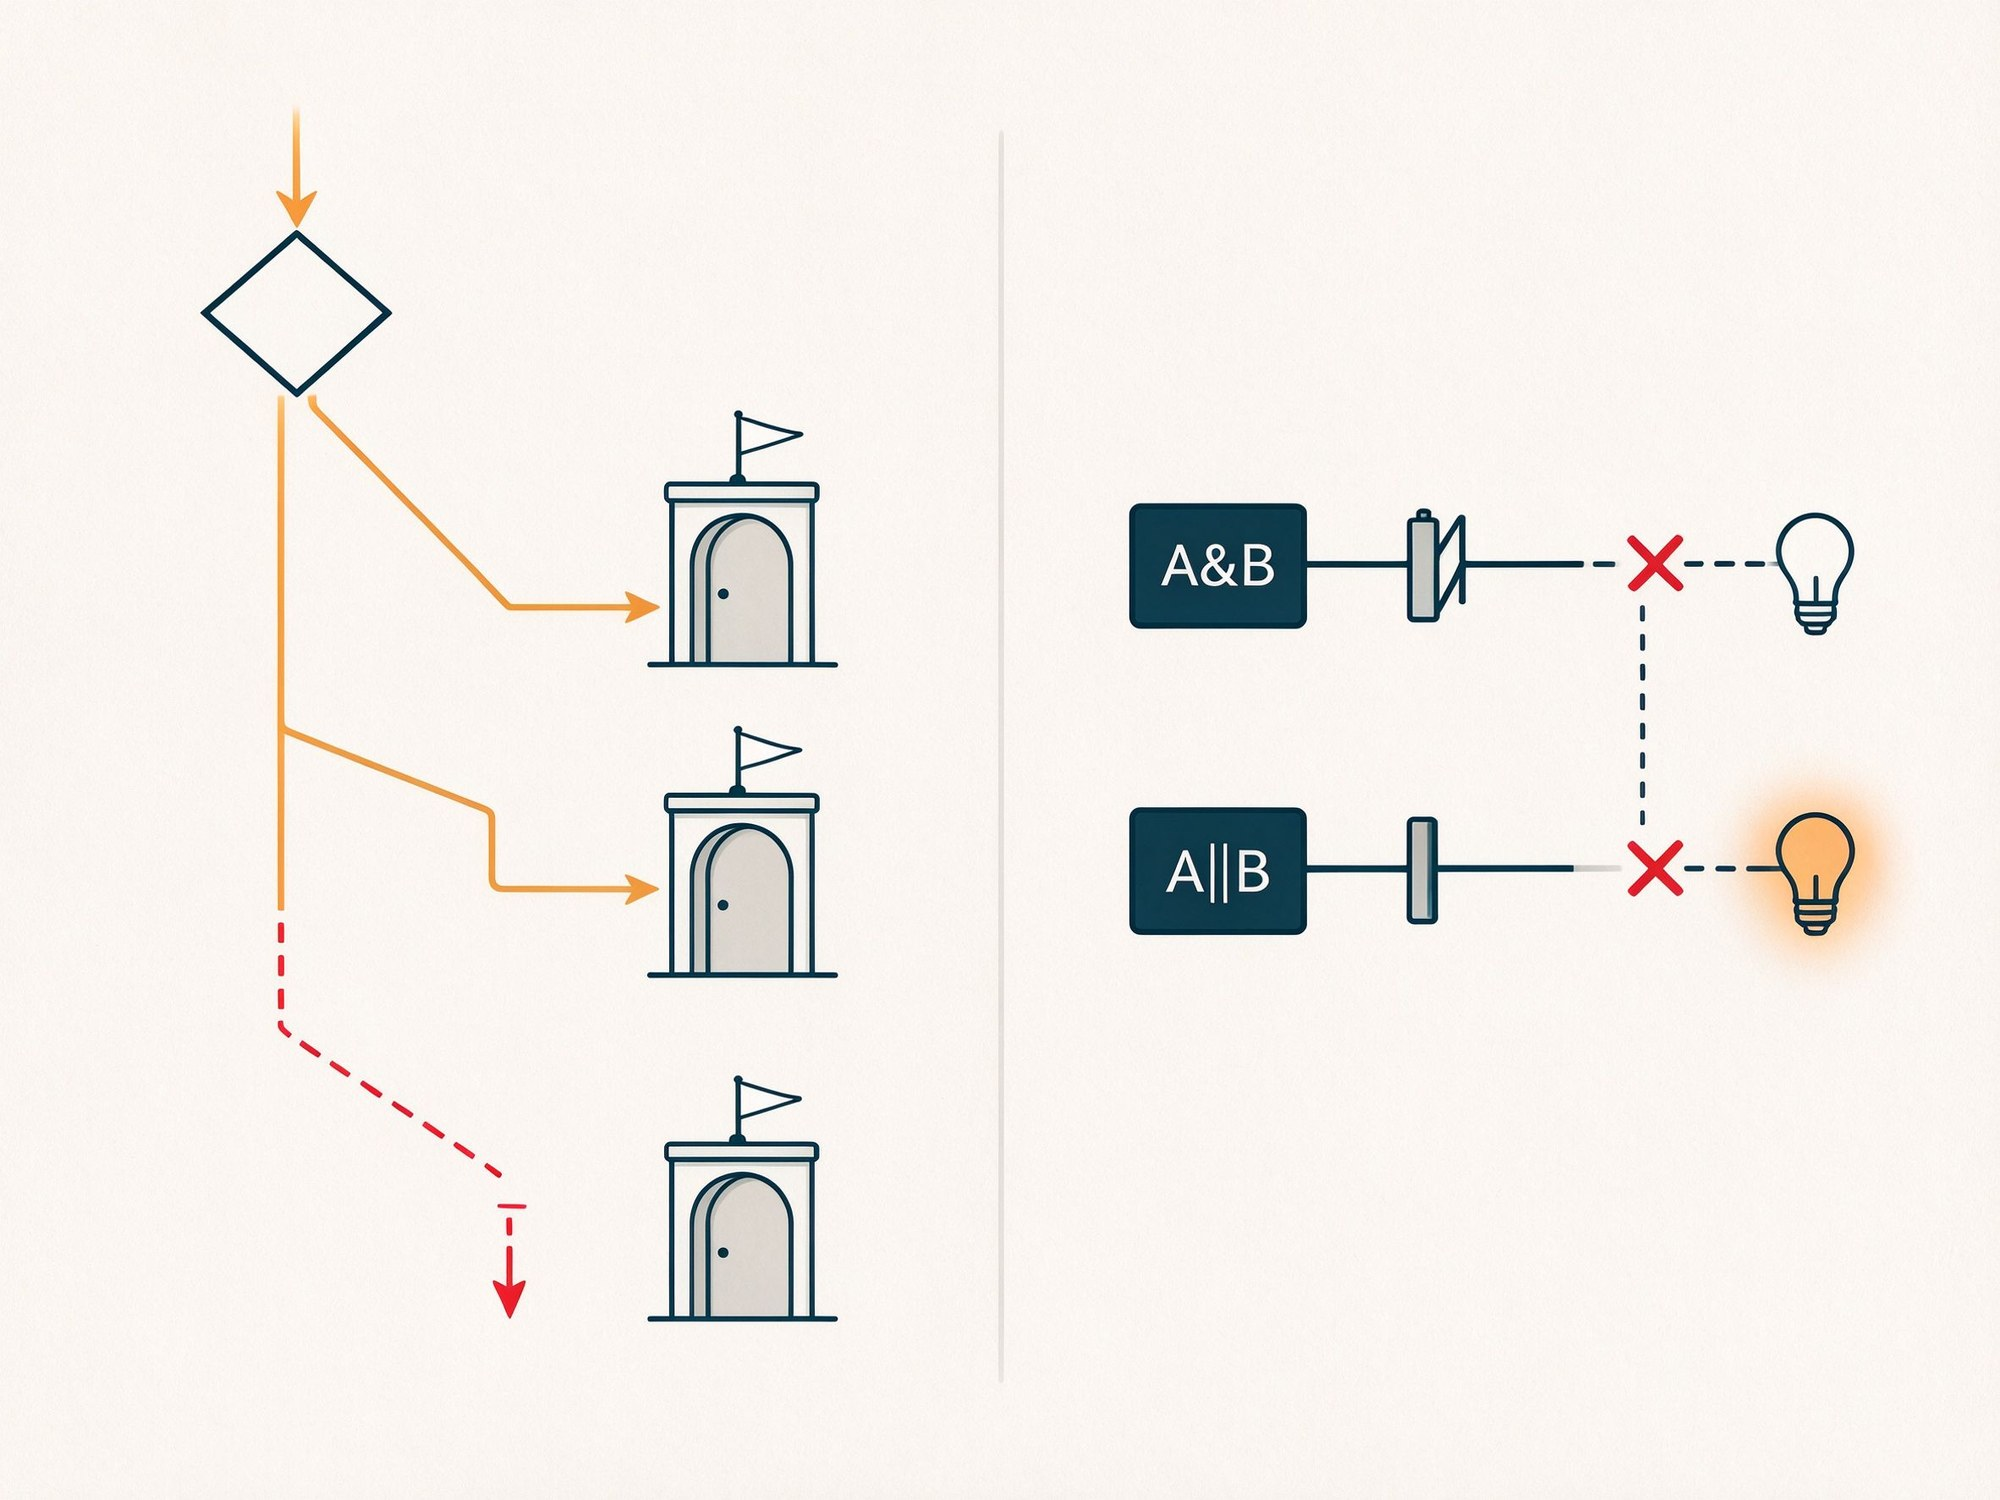
图5 左:每条分支都要有去处;右:与、或运算的短路跳过
判定条件还可以组合判定,用到最基础的三个逻辑连接词:与、或、非。它们的规则,一张真值表就能看明白。
|
A |
B |
A 且 B(&&) |
A 或 B(||) |
|
成立 |
成立 |
成立 |
成立 |
|
成立 |
不成立 |
不成立 |
成立 |
|
不成立 |
成立 |
不成立 |
成立 |
|
不成立 |
不成立 |
不成立 |
不成立 |
我们先看“且”,也就是表格里的“&&”,从表格里不难读出,只有 A、B 两个条件同时成立,最终结果才成立。只要任意一个条件不成立,整体结果一定不成立。再看“或”,也就是“||”,只要 A、B 当中任意一条成立,结果就成立;只有两者全都不成立,最终结果才是不成立。
第三个逻辑词 “非” 就更简单,它不需要两个条件,只对单一条件取反:成立,就变成不成立;不成立,就变成成立。
这张表给出的,仅仅是表达式最终应当输出的真假答案,它不会记录计算机真实的执行路径。这里就引出一个表格不会写明的运行机制——短路求值。
我们再回头看表格,对于“且”运算,一旦左边条件判定为不成立,无论右边是真还是假,查表就能确定最终结果必然是不成立。既然结局已定,计算机何必再去计算后半句?它会直接停下,跳过右侧代码。同理,“或” 运算只要左边判定成立,查表可知整体一定成立,后半段同样直接放弃执行。
就算我们把真值表、与或非、短路都弄懂了,实际操作中里依旧会出现逻辑判断问题。下面给大家梳理几类最高发的典型问题。
第一类,就是大家常说的「边界差一」。举个例子,考试规定60 分及以上才算及格。如果你写代码的时候随手写成大于 60,那刚好考到 60 分的同学,就会被判定为不及格。这类错误,不是逻辑推理不行,是没有把自然语言里的 “及以上”,准确翻译成带上等号的比较表达式。边界点很容易被漏掉。
第二个坑,浮点小数的相等判断。大家都听过:在计算机里,0.1 加上 0.2,结果并不严格等于 0.3。根源在于计算机以二进制保存小数,像 0.1 这类十进制小数,无法被二进制精确表达,存入内存的时候就已经被近似截断,自带了一丝微小误差。当我们把带有误差的数值继续运算,偏差就会逐步累积、显现出来。所以但凡处理金额、传感器测量值这类小数场景,切忌直接用等号去判定相等;正确的做法是划定一个极小的容差区间,只要两个数的差值落在这个区间以内,我们就认定它们相等。
第三个,把比较判断写成了赋值。这是经典坑,几乎每一个写代码的人都踩过。条件里本该用双等号“==”判断相等,一不小心写成单个等号赋值。赋值操作本身一定会成功,这个条件就会恒为真,分支永远往同一个方向走。它不会报语法错误,程序可以运行,但程序的判断逻辑已经发生了变化。
最后条件分支不完备,只写了如果,忘了兜底的否则。如你写下两条规则:如果及格就表扬,如果不及格就安排补考。听起来好像覆盖全部情况,可还有缺考呢?缺考的分数,既不属于及格,也不属于不及格,两条分支全都进不去,程序会直接跳过,什么都不做。写分支的原则是:把所有可能出现的情况全部梳理清楚,每一类输入都要有明确去向;就算剩下的情况确实不需要处理,也最好显式写上兜底分支,而不是寄希望于漏掉就不管了。
分支的难点,从来不是写对布尔表达式,而是把人类语境里所有隐性情况,全部梳理出来,给每一类输入安排明确出口。
4.循环:重复很简单,最难是可控停止
重复计算,是计算机相比人类最擅长的事情。。人工统计几十份数据容易疲惫出错,计算机循环上万次,始终稳定一致。但凡同质重复任务,都适合交给循环。
但循环有一个绕不开的核心问题:什么时候停下来。如果停止条件失效,就会进入死循环,程序卡住、资源持续占用,只能强制终止。
一段能够完整运行的循环代码,有三个必不可少的组成部分,少了任何一个,循环都容易出问题。
第一是初始化:在循环开始之前,把循环变量设置好初始值。如我们打算从 1 数到 10,就要先把计数器置为 1。如果忘了初始化,变量里面是随机的脏数据,循环从哪开始,完全不受你的控制。
第二是循环判定条件:也就是什么时候继续转循环、什么时候停下来。这个条件是循环停止的必要条件。条件写得太松,它停不下来,就是我们常说的死循环;条件卡得太严,它可能一次都不肯执行,直接跳过整段逻辑。
第三是迭代更新:每一轮循环结束,一定要修改那个决定循环能不能停下的变量。计数器要加1、或者往回递减。很多初学者初始化写了、条件也写对了,偏偏漏掉这一步,变量的值永远不变,循环停止的条件永远无法触发,程序就卡在原地无限循环。
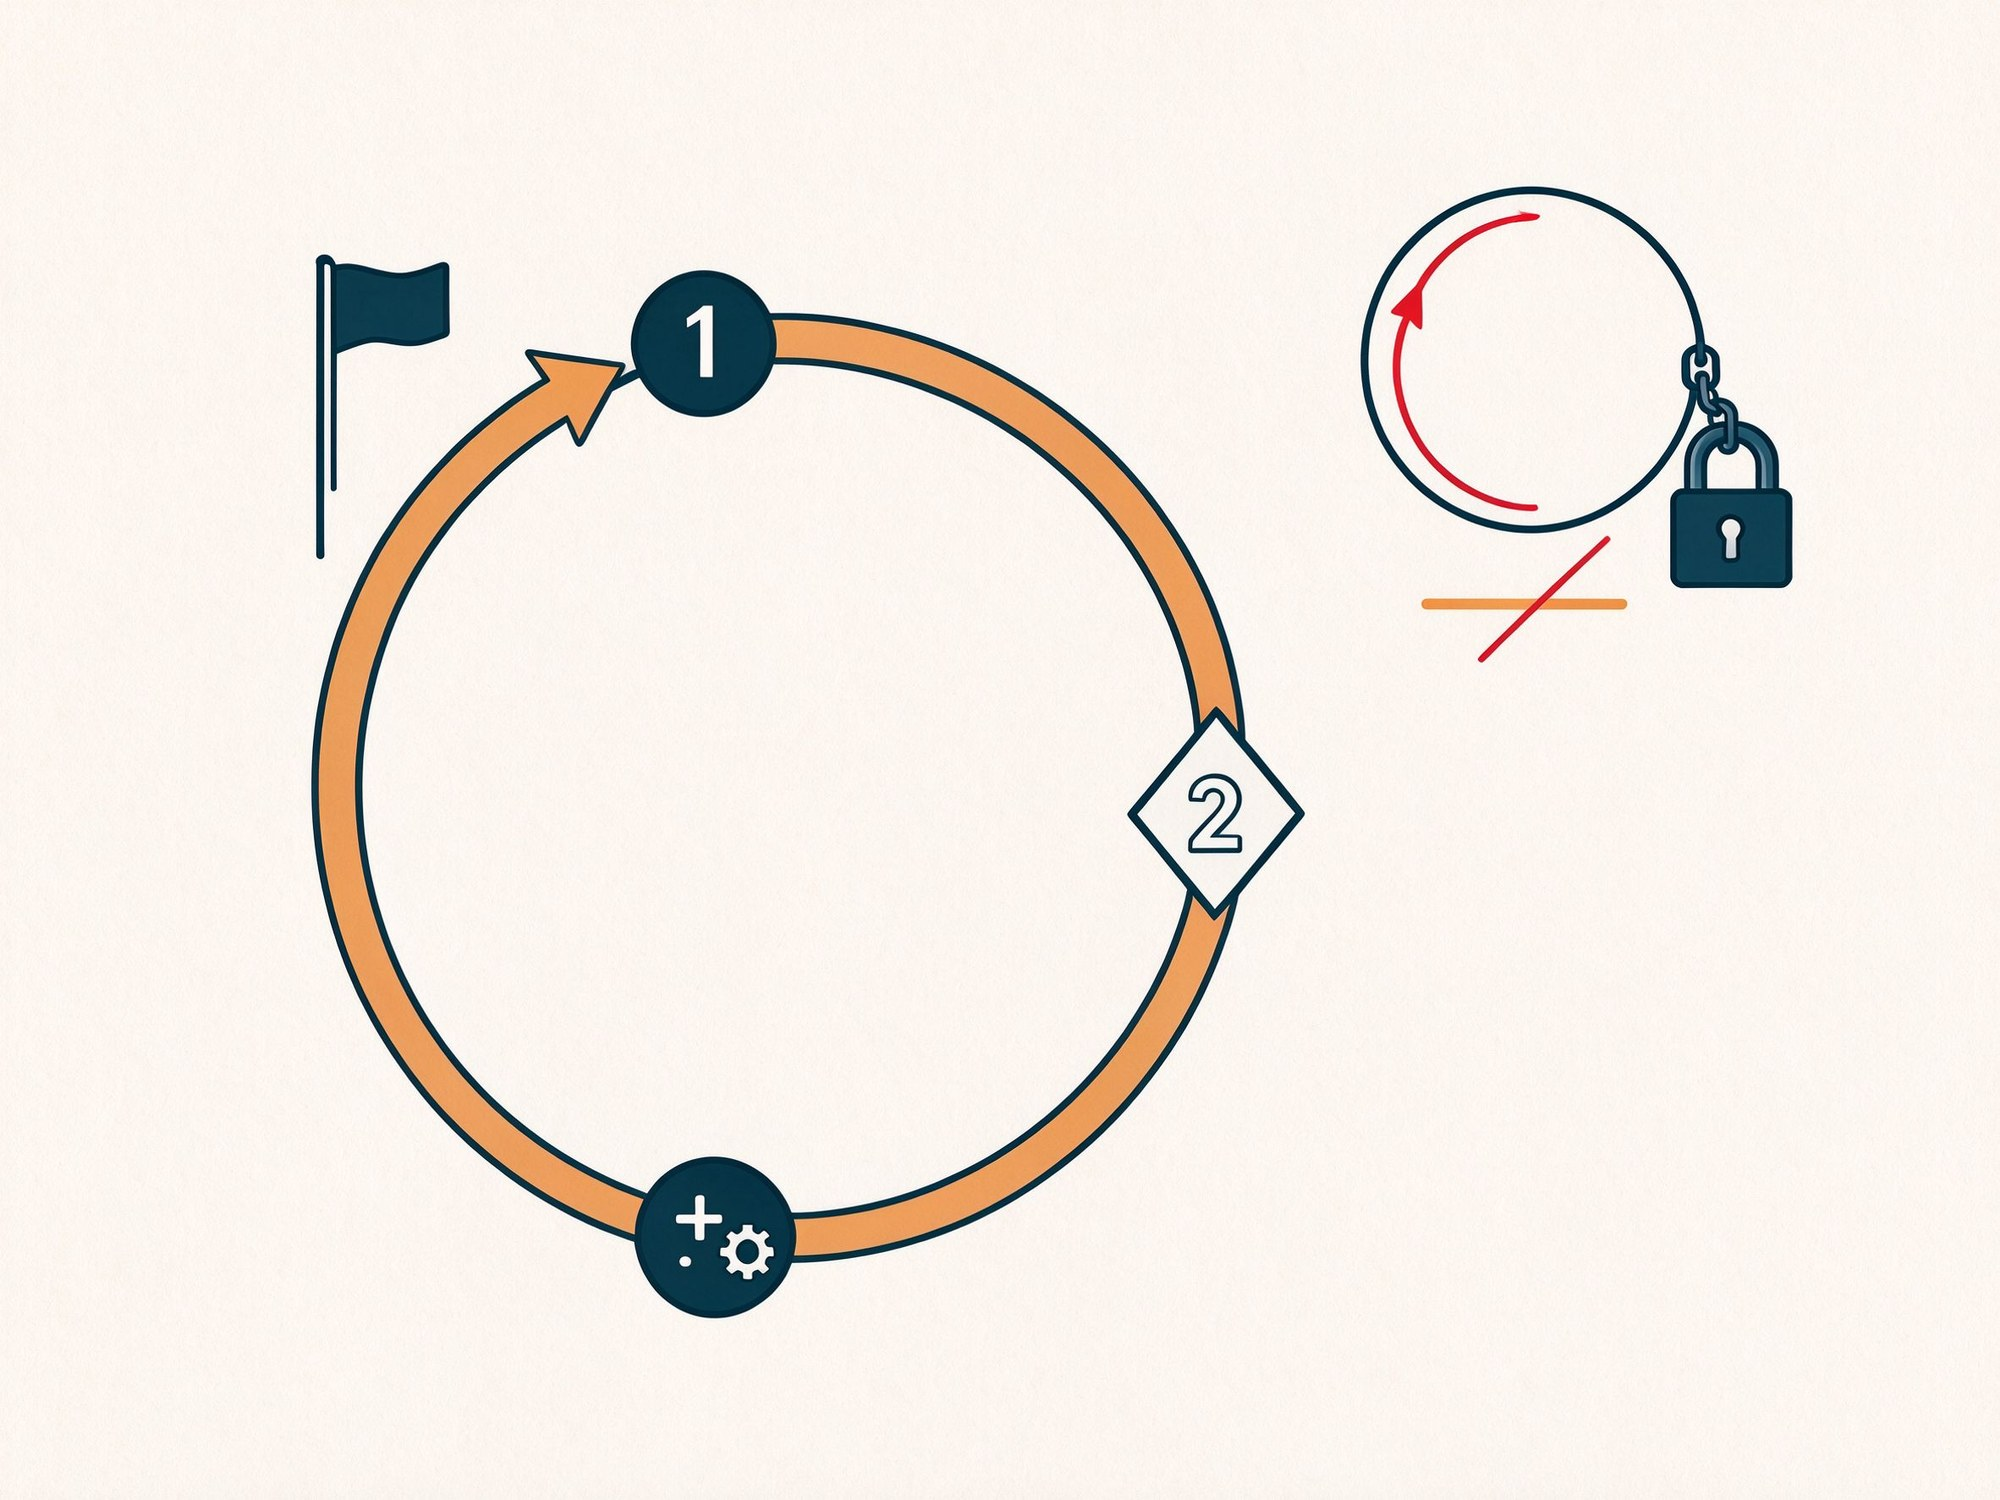
图6 循环的三要素;缺了迭代更新,循环就锁死在这里
循环最容易发生的错误,就是程序员经常碰到的“差一错误”。想循环 10 次,结果跑了 9 次或者 11 次,根源大多就在条件和迭代没有配合好。它和之前分支里的边界问题,本质是同一种毛病:人类心里明白到这里为止,却没能给机器划一条精准的停止线。
循环的核心不是重复,是拥有一条一定会抵达的退出路径。
5.变量:一个带门牌的储物柜
很多人以为变量就是数学里的 x,一个会变的数。这个理解会让你在后面栽跟头。更准确的理解变量的画面是储物柜。
储物柜刚好可以用来类比变量的几个核心特性。柜子的编号,就是变量名,我们依靠这个名字定位到对应的存储空间;柜子的大小,对应数据类型,小柜子装不下体积更大的行李,类型决定了这里能存放什么样的数据。
同一个储物柜,同一时刻只能存放一份内容:如果你往里放入新东西,原来存放的内容就会被直接覆盖,新旧无法共存。柜子钥匙的有效期限,对应的就是变量的作用域与生命周期,出了这个范围,你就再也访问不到这个柜子。还有一点尤其要注意:拿到柜子的时候,它未必是空的,里面可能留着上一个使用者遗留的物品,这就是我们之前提到的、未初始化的变量。
理解了变量的实质,对变量的误解会自动消失。
误解一:赋值是“两边相等”。不是。赋值的动作方向很明确——把右边的东西装进左边的柜子。左边原来装的是什么,被覆盖掉了,一点不剩。所以“把甲的分数赋给乙”,乙原来的分数就消失了,不是两个分数并存。
误解二:变量会记住历史内容。不会。它只保留最后一次放进去的东西。你要统计累加,就得写成“柜子里原来的数加上新的数,再放回柜子”,缺了“放回”这一步,每一轮都是从头算,最后柜子里只有最后一个数。
误解三:出了大括号还能用。不能。变量只在它被声明的那对括号里活着,出了括号,门牌号就失效了,柜子用完就腾出来,别人不会误拿到你的东西。
如果你声明了一个变量没有赋值,它里面就是内存里的残留数据,可能是零,也可能是一个奇怪的数。它不会报错,它会带着那个奇怪的数一路算下去,最后给你一个错得毫无道理的结果。所以使用变量的规则:先对变量赋值,再使用变量。
6.实战:把猜数字说成人话
下面我们通过一个猜数字的案例,来验证我们前面掌握的内容。
案例:编写一个程序,让计算机在 1 到 100 之间想一个整数;玩家来猜,每次猜完,计算机告诉他“大了”,或者“小了”,或者“对了”;一共给七次机会,猜中就结束,七次用完还没中就算失败。
现在要做的第一件事,就是把编程需求变换为能照着执行的流程。
整个游戏从头到尾,需要维护4个变量
(1)目标数target:是一个1到100之间的随机整数,游戏一开始就生成好,本论游戏里绝对不会变。
(2)有效尝试次数count:专门记录用户猜对了多少次合法的数字,一开始是0;只有通过校验的猜测,才会让这个数字加1。
(3)当前输入guess:临时存用户这一轮刚输入的内容,每一轮新的交互都会把它刷新成新的输入。
(4)命中标记hit:是个真或假的开关,用来标记用户有没有猜对数字,一开始默认是“没猜对”也就是false。
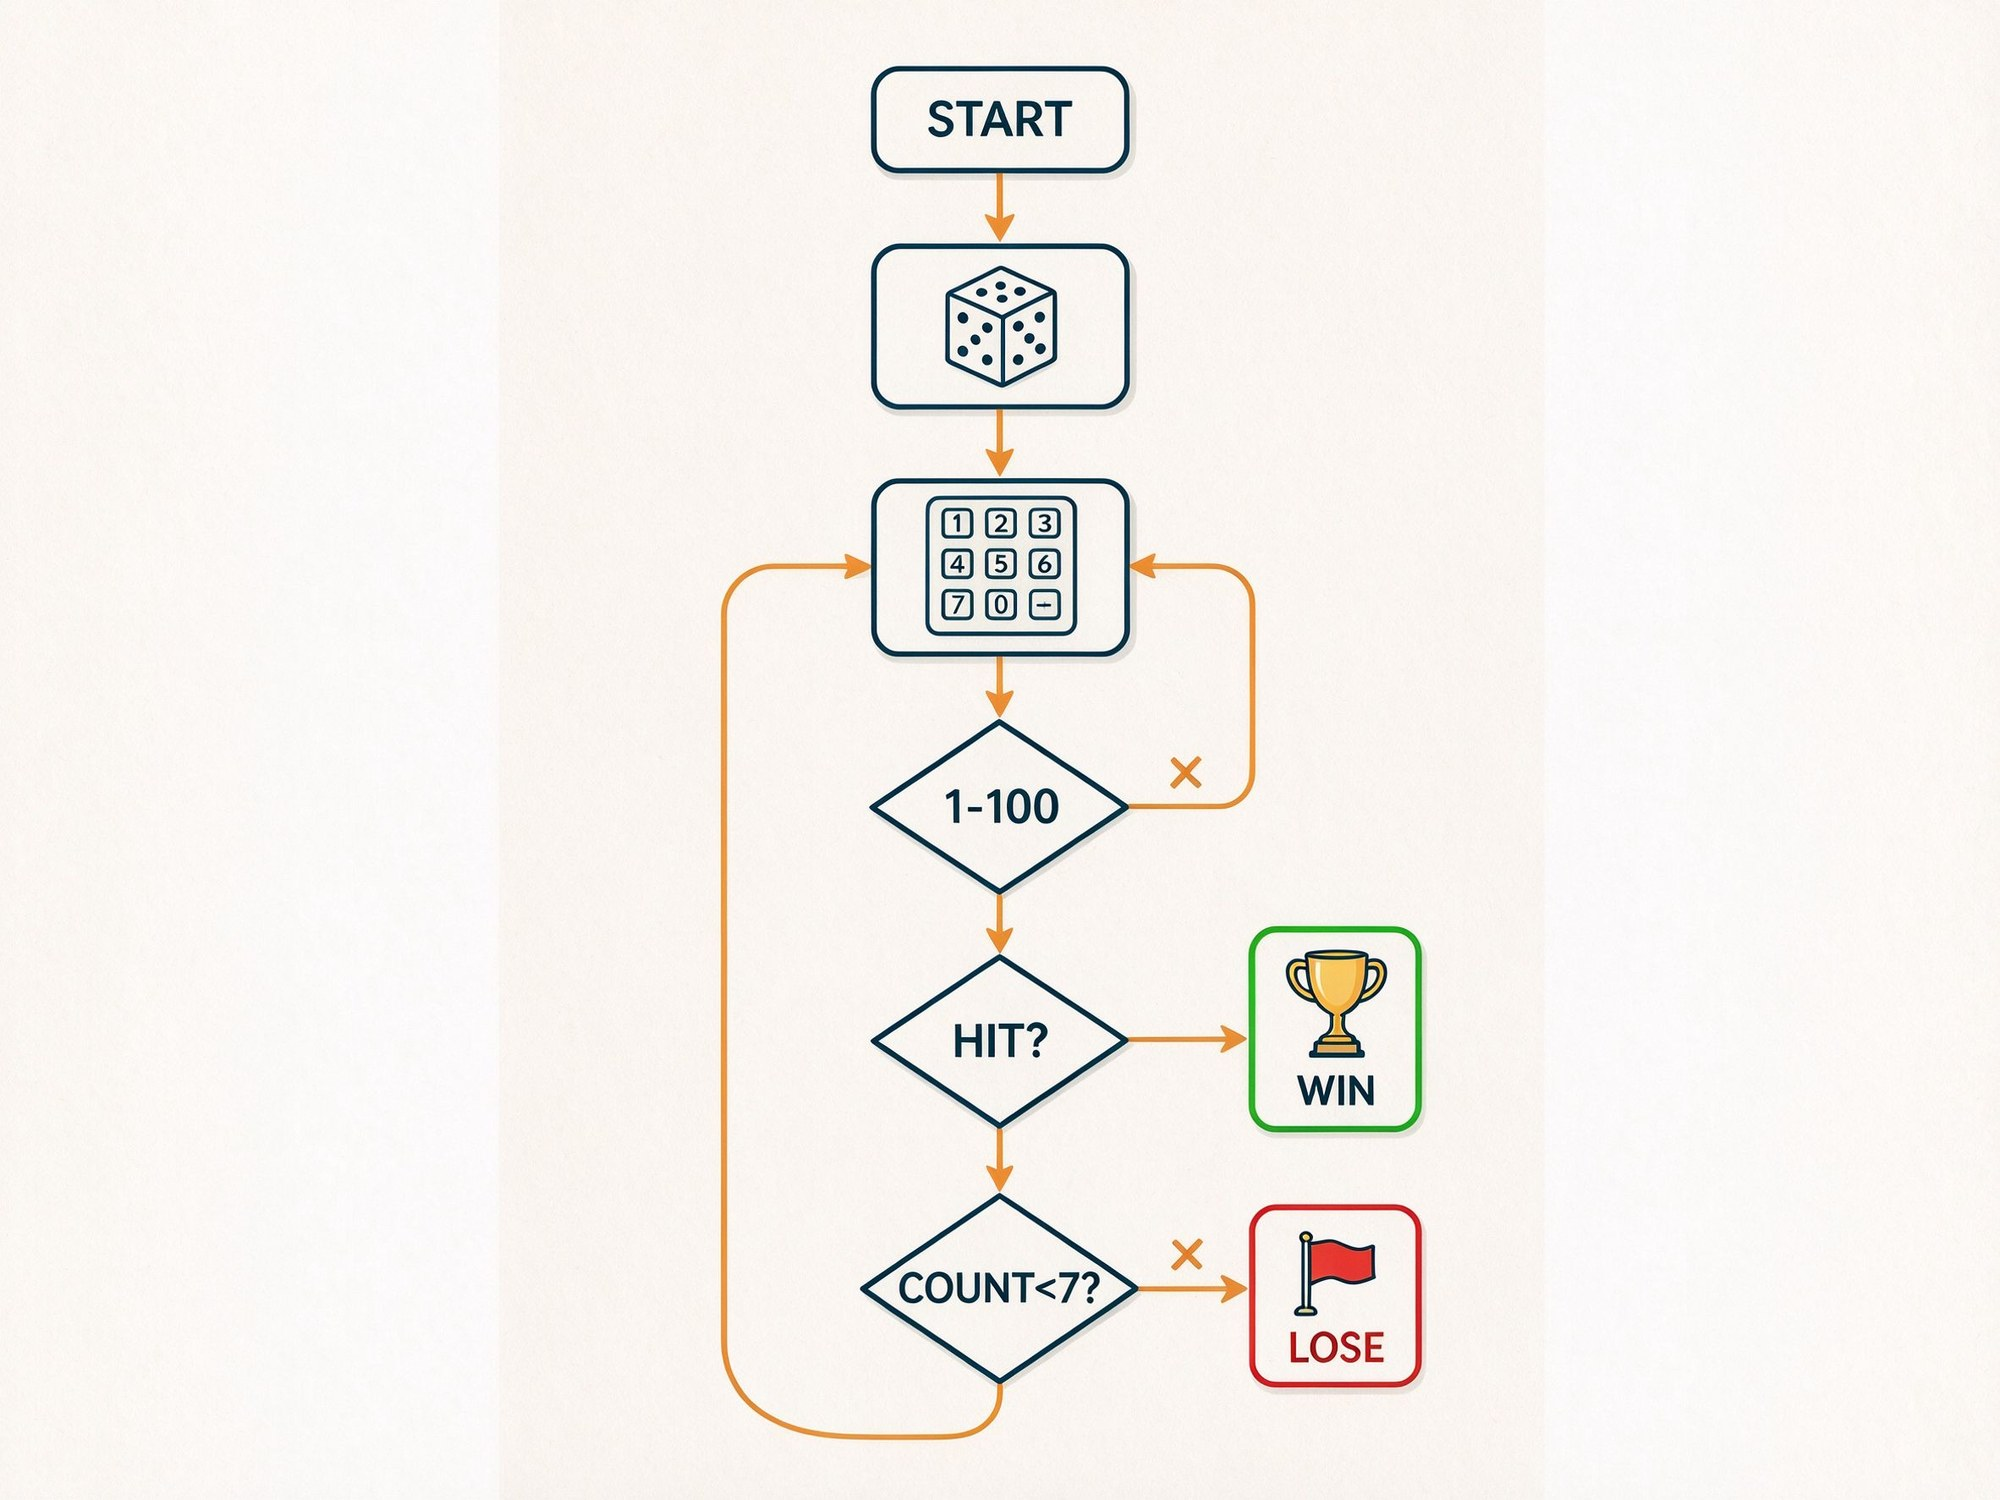
图8 猜数字的流程:输入校验、命中判断与七次机会的边界
每一轮合法猜数的固定顺序
每一次的猜数,都必须严格按这个先后顺序走,不能乱序,不然就会出现数错次数、提前把机会用掉的bug:
(1)获取用户的输入
(2)检查输入合不合法
(3)只有检查通过了,才让尝试次数加1
(4)把用户猜的数和目标数比对,给用户对应的提示
(5)要是输入不合法,直接返回让用户重新输入。
最多只能猜7次的有限循环
绝对不让游戏无限循环下去,给它设好明确的边界:
(1)游戏刚开始的时候:尝试次数是0,命中标记是“没猜对”
(2)能继续猜的条件:用户还没猜对,而且尝试次数还没到7次
(3)每一次合法的猜数都会让尝试次数加1,最多只能猜7次,到次数游戏就自动结束。
用上述方式先在自然语言层面把所有步骤、边界情况都理清楚,提前把数错次数、逻辑漏项、非法输入捣乱这些常见的小bug都提前规避掉,之后不管你用C语言还是其他编程语言写代码,都只是把这些规则翻译成对应代码。